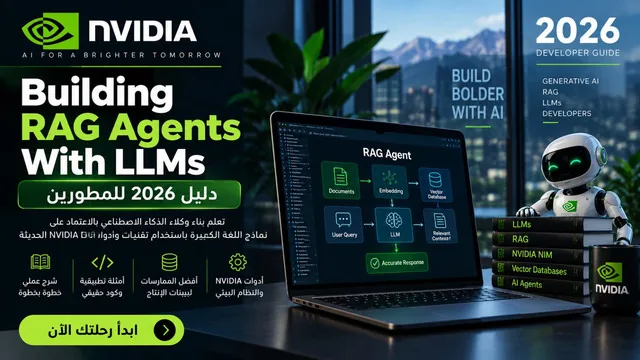
Building RAG Agents With LLMs من NVIDIA دورة تقنية مدتها 8 ساعات، تركز على تصميم أنظمة الاسترجاع المعزز بالتوليد، إدارة الحوار، embeddings، vector stores، الأدوات والتقييم. تتطلب أساسيات التعلم العميق و Python، وتتوفر بنمط ذاتي مدفوع بقيمة 90 دولار وفق صفحة NVIDIA الحالية.
تُعد دورة NVIDIA Building RAG Agents With LLMs الخيار الأبرز للمطورين الراغبين في إتقان تقنيات الذكاء الاصطناعي التوليدي عبر بناء أنظمة استرجاع متقدمة. تُقدم الدورة محتوىً عملياً مدته 8 ساعات وفقاً للمصادر الرسمية لشركة NVIDIA، بتكلفة 90 دولاراً للنمط الذاتي. يعتمد هذا الدليل على تحليل دقيق لبيانات المطورين لتمكينك من فهم تفاصيل الاستدلال، إدارة الحوار، واستخدام embeddings، و vector stores بكفاءة عالية في مشاريعك البرمجية لعام 2026.
الحقائق سريعة (وفقاً لموقع NVIDIA الرسمي)
- تُعد المدة الزمنية المعتمدة للدورة التدريبية 8 ساعات وفقاً لصفحة NVIDIA الحالية.
- تبلغ تكلفة النمط الذاتي للدورة 90 دولاراً أمريكياً بناءً على بيانات المنصة الرسمية.
- يشير المنهج التقني إلى استخدام أدوات متعددة تشمل LangChain و FastAPI و Gradio لتطوير النماذج.
- تتطلب الدورة خلفية برمجية مسبقة في لغة Python ومعرفة بأساسيات التعلم العميق والشبكات العصبية.
دليل كورس NVIDIA Building RAG Agents With LLMs وإدارة نماذج اللغة
يبدأ المسار من طبقة الاستدلال والتعامل مع نقاط الوصول إلى نماذج اللغة. الهدف للمطور هو فهم كيف يمكن تركيب عدة مكونات في خط معالجة واحد، وكيف تُدار الخدمات أو الواجهات التي توفر inference. هذه النقطة مهمة لأن التطبيق الحقيقي لا يتعامل مع النموذج كصندوق منفصل، بل يربطه ببيانات وواجهات وأدوات وطبقات تحكم.
وتذكر NVIDIA ضمن مخطط الدورة تقنيات مثل LangChain و LangServe و Gradio و FastAPI، إضافة إلى نقاط نهاية NVIDIA AI Foundation. وجود هذه الأدوات يجعل الدورة أقرب إلى بناء تطبيق فعلي من كونها درسًا نظريًا عن RAG.
تطبيقات كورس NVIDIA Building RAG Agents With LLMs والـ Embeddings
الـ embeddings تحول النصوص إلى تمثيلات رقمية يمكن استخدامها للمقارنة الدلالية. في تطبيق RAG، لا يكفي أن تبحث عن تطابق الكلمات حرفيًا؛ المطلوب غالبًا هو العثور على المقاطع التي تحمل معنى قريبًا من السؤال. لذلك يتعلم المطور كيف تدخل التمثيلات المتجهية في عملية الاسترجاع، وكيف يمكن استخدامها أيضًا ضمن آليات الحماية أو guardrailing.
النتيجة العملية هي فهم سبب اختيار مقطع معين من قاعدة المعرفة بدل مقطع آخر، وليس مجرد تشغيل مكتبة بحث جاهزة. هذه المهارة تساعد على تشخيص الحالات التي تكون فيها إجابة النموذج ضعيفة بسبب استرجاع سياق غير مناسب.
المستندات والتقسيم قبل بناء RAG
المستند الطويل لا يدخل دائمًا إلى نموذج اللغة ككتلة واحدة. لذلك تتناول الدورة العمل مع المستندات التي تتجاوز حدود السياق، بما في ذلك chunking وأساليب الاختزال والتنقيح. اختيار حجم المقاطع وطريقة تقسيمها يؤثر مباشرة في جودة الاسترجاع؛ فالمقطع الصغير جدًا قد يفقد السياق، والمقطع الكبير جدًا قد يضيف معلومات غير مرتبطة بالسؤال.
منهج عملي مناسب هو اختبار أكثر من استراتيجية على مجموعة أسئلة معروفة، ثم قياس جودة النتائج بدل افتراض أن إعدادًا واحدًا يصلح لكل البيانات. هذا جانب مهم من منظور التطوير؛ لأن RAG الجيد هو نظام يتم اختباره وتحسينه، وليس قالبًا ثابتًا.
Vector Stores ودورها الأساسي في RAG
بعد تحويل المستندات إلى embeddings، تحتاج المنظومة إلى طريقة للعثور على المتجهات الأقرب إلى استعلام المستخدم. هنا تظهر vector stores. تشرح NVIDIA في الدورة كيف تُستخدم مخازن المتجهات لمساعدة الوكيل على استرجاع المعلومات والتفكير فيها، مع ربطها بسياق المحادثة ومجموعات المستندات التي جرى تجهيزها مسبقًا.
الفكرة الأساسية التي ينبغي أن يخرج بها المطور هي أن قاعدة المتجهات ليست الهدف النهائي. قيمتها تأتي من قدرتها على توفير سياق مناسب للنموذج في الوقت المناسب. إذا كانت البيانات سيئة أو embeddings غير مناسبة أو الاستعلام ضعيفًا، فلن تنقذ قاعدة المتجهات وحدها جودة الإجابة.
إدارة الحوار والحالة داخل الوكيل
RAG agent أكثر تعقيدًا من استعلام واحد ثم إجابة واحدة. عندما يتفاعل المستخدم في عدة خطوات، يحتاج النظام إلى الاحتفاظ بحالة مناسبة للحوار ومعرفة ما تم استرجاعه وما الذي يحتاج إلى استكمال. تتناول الدورة running states وإدارة الحوار، إضافة إلى أساليب مثل slot filling لاستخراج معلومات منظمة من تفاعل المستخدم.
هذه الطبقة مهمة عند بناء مساعد يتعامل مع أسئلة متتابعة. فبدل إعادة بناء السياق من الصفر في كل رسالة، يستطيع التطبيق إدارة حالة المحادثة بطريقة منظمة. وفي التطبيقات الحقيقية يجب تحديد ما الذي يُحفظ، ومدة الاحتفاظ به، وكيف تُمنع المعلومات غير الضرورية من تلويث السياق.
المدة الزمنية لدورة NVIDIA Building RAG Agents With LLMs
المدة المعلنة للدورة الذاتية هي 8 ساعات. لا يعني ذلك أن كل متعلم سينهيها في ثماني ساعات بالضبط؛ وقت التطبيق والمراجعة وتجربة الأكواد قد يضيف ساعات أخرى. أما النسخة التي يقدمها مدرب فتظهر أيضًا ضمن ورش NVIDIA بمدة 8 ساعات، مع تقسيم زمني واضح لموضوعات الاستدلال، وتصميم خطوط LLM، وإدارة الحوار، والمستندات، والـ embeddings، و vector stores، ثم التقييم.
لذلك يمكن التعامل مع 8 ساعات باعتبارها مدة المحتوى التدريبي المعلنة، وليس وعدًا بمدة دراسة شخصية ثابتة.
الشهادة والاعتماد المنهجي
توضح صفحات NVIDIA أن النسخة الذاتية من Building RAG Agents With LLMs مدرجة مع إمكانية الحصول على شهادة، كما تذكر نسخة الورشة أن إكمال التقييم بنجاح يؤدي إلى شهادة NVIDIA DLI. يجب التمييز بين شهادة إتمام دورة تدريبية وبين شهادة مهنية مستقلة؛ إكمال هذه الدورة لا يعني تلقائيًا حصول المتعلم على اعتماد احترافي منفصل.
إذا كنت تستخدم الدورة في سيرتك الذاتية، اكتب الاسم الدقيق للشهادة التي حصلت عليها فعلًا، ولا تخلط بينها وبين شهادات NVIDIA المهنية الأخرى.
الأدوات والتقنيات المستخدمة في المسار
وفق مخطط NVIDIA للورشة، تشمل التقنيات Python و LangChain و NVIDIA AI Foundation Endpoints و FAISS و Gradio و LangServe و FastAPI. هذه المجموعة تعطي المطور تصورًا عن الطبقات المختلفة في تطبيق RAG: نموذج اللغة، الاسترجاع المتجهي، orchestration، الواجهة، وخدمة التطبيق.
ولا تحتاج إلى حفظ أسماء الأدوات فقط. الأفضل فهم الدور الذي يؤديه كل مكون. مثلًا، FAISS يرتبط بالبحث المتجهي، بينما LangChain يساعد في تركيب مكونات تدفق التطبيق، و FastAPI يمكن أن يكون طبقة لخدمة التطبيق، و Gradio يوفر واجهة تفاعلية مناسبة للتجارب والعروض.
تقييم جودة RAG بعد بناء النظام
من أكبر الأخطاء اعتبار أن ظهور إجابة لغوية جيدة يعني أن النظام ناجح. قد تكون الإجابة مصاغة بشكل ممتاز لكنها مبنية على سياق غير مناسب. لهذا تضع NVIDIA التقييم في نهاية مسار الدورة، وتذكر استخدام LLM-as-a-Judge ضمن عملية تقييم نظام RAG.
منهج عملي لـ Alhegra في تقييم أي دورة RAG هو تقسيم النتيجة إلى ثلاث طبقات: جودة الاسترجاع، ثم ملاءمة السياق، ثم دقة الإجابة النهائية. هذه المنهجية تساعد على تحديد مكان الخلل بدل إعطاء النظام درجة واحدة غير قابلة للتفسير. فإذا كانت الإجابة خاطئة لأن الوثيقة الصحيحة لم تُسترجع، فالمشكلة في retrieval وليست بالضرورة في النموذج.
هل الدورة مناسبة للمبتدئين في الذكاء الاصطناعي؟
لا. NVIDIA Building RAG Agents With LLMs مناسبة أكثر للمطورين الذين يريدون الانتقال من فهم LLMs إلى بناء تطبيقات تعتمد على الاسترجاع والوكلاء. الشخص الذي يبدأ من الصفر في البرمجة قد يجد الدورة سريعة، بينما المطور الذي لديه Python وفهم أساسي للتعلم العميق سيجد موضوعاتها أكثر ارتباطًا بمشكلات عملية.
إذا كان هدفك مجرد التعرف على الذكاء الاصطناعي التوليدي، فهناك مسارات تمهيدية أبسط لدى NVIDIA. أما إذا كان هدفك بناء نظام يستطيع البحث في مجموعة مستندات ثم توليد إجابة مرتبطة بها، فمسار RAG أكثر صلة.
تكلفة وخصائص كورس NVIDIA Building RAG Agents With LLMs
هذه النقطة تحتاج إلى تدقيق لأن عروض NVIDIA تتغير. صفحة NVIDIA الخاصة بمسار Generative AI and LLM تعرض النسخة الذاتية من Building RAG Agents With LLMs ضمن الدورات ذات السعر المعلن بقيمة 90 دولار، بينما تعرض بعض صفحات NVIDIA أو العروض الخاصة دورات RAG مجانًا لفترات أو شروط معينة. لذلك لا تعتمد على كلمة مجاني وحدها عند اتخاذ القرار؛ افتح صفحة الدورة في يوم التسجيل وتحقق من السعر وشروط العرض.
في المقابل، توجد بالفعل دورات تمهيدية مجانية في مسار NVIDIA نفسه، مثل بعض الدورات التعريفية في Generative AI و RAG، ولذلك يمكن للمبتدئ استخدام المحتوى المجاني لبناء أساس قبل الانتقال إلى الدورة المتخصصة.
الفرق بين RAG التقليدي و Agentic RAG
في RAG التقليدي قد يمر الطلب في مسار مباشر: تحويل السؤال إلى embedding، استرجاع عدد من المقاطع، ثم تمرير السياق إلى نموذج اللغة. هذا مناسب للأسئلة المباشرة. أما Agentic RAG فيضيف طبقة قرار؛ يمكن للنظام أن يخطط لخطوات الاسترجاع، يقسم السؤال إلى مهام، يعيد صياغة الاستعلام عندما تكون النتائج ضعيفة، ثم يجمع المعلومات قبل صياغة الإجابة.
هذه الفكرة تفسر لماذا تجمع الدورة بين retrieval و LLM orchestration وإدارة الحوار والتقييم. المطور لا يبني بحثًا متجهيًا فقط، بل يبني نظامًا قادرًا على اتخاذ قرارات داخل سير العمل.
كيف تستفيد من الدورة كمطور في عام 2026؟
أفضل طريقة ليست مشاهدة الساعات الثماني ثم إغلاق الدورة. بعد كل محور، طبّق المفهوم على مجموعة مستندات صغيرة. ابدأ بتجهيز البيانات وتقسيمها، ثم أنشئ embeddings، ثم أضف البحث المتجهي، وبعد ذلك اربط النتائج بنموذج اللغة. في المرحلة التالية أضف إدارة الحالة والتقييم.
يمكنك أيضًا بناء مشروع صغير يشبه قاعدة معرفة شخصية: مجموعة وثائق تقنية، واجهة سؤال وجواب، سجل للاستعلامات، وقياس بسيط لجودة الاسترجاع. بهذه الطريقة يصبح ما تعلمته في الدورة مادة يمكن عرضها في portfolio بدل أن يبقى مجرد شهادة.
الخلاصة: هل تستحق دورة NVIDIA Building RAG Agents With LLMs وقتك؟
NVIDIA Building RAG Agents With LLMs خيار متخصص للمطورين الذين يريدون فهم RAG على مستوى بناء النظام، وليس فقط معرفة تعريفه. المدة المعلنة 8 ساعات، والمتطلبات تشمل Python بمستوى متوسط وخلفية تمهيدية في التعلم العميق، بينما تشمل الموضوعات الأساسية LLM orchestration، المستندات، embeddings، vector stores، إدارة الحوار والتقييم.
قيمة الدورة الحقيقية تظهر عندما تستخدم ما تتعلمه لبناء نظام قابل للاختبار والتحسين. ومنهج Alhegra المقترح هو ألا تقيس نجاح مشروع RAG بجمال الإجابة فقط؛ قِس جودة الاسترجاع، وملاءمة السياق، ودقة الإجابة بصورة منفصلة. وإذا كنت تبحث عن مسار أوسع، يمكنك مراجعة قسم الكورسات المجانية ومقارنة الدورة مع مسارات NVIDIA التمهيدية.